精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
锐英源精品原创,禁止转载和任何形式的非法内容使用,违者必究
文本文件里的字符是用数字表示的,数字按哪类体系组织,是根据标准定义。就像现实生活中的铁轨间距,中国和苏联的不一样,就是标准不一样。
不同的标准在文件头带有前缀不一样,这样的前缀就是BOM识别编码,网页html里最常用的UTF-8无BOM格式,就没有前缀,使用最广泛。
常见的BOM识别编码有:
| 编码格式 | BOM 字节序列 (Hex) | 说明 |
|---|---|---|
| UTF-8 | EF BB BF | UTF-8 无字节序问题,BOM 仅用于标识“这是 UTF-8 文件”。Windows 记事本默认添加,但 Web 开发中通常建议去除 [2][6]。 |
| UTF-16 LE (小端序) | FF FE | 常见于 Windows 系统生成的文本文件。你之前遇到的 FF FE 3C 即为此类,3C 是 < 的小端编码 [2][6]。 |
| UTF-16 BE (大端序) | FE FF | 较少见,某些 Unix/Linux 环境或 Java 默认可能使用 [7]。 |
| UTF-32 LE (小端序) | FF FE 00 00 | 用于固定4字节宽度的 Unicode 编码 [2][6]。 |
| UTF-32 BE (大端序) | 00 00 FE FF | 同上,大端序版本 [2][6]。 |
最近因为查网站索引量问题,偶然用旧版本UltraEdit32位查看html文件,按十六进制查,发现有前缀,就很紧张,压力大。UltraEdit32位查看的图片如下:
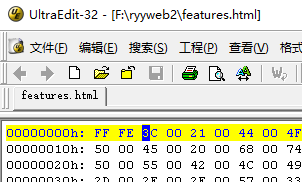
出现这情况,查AI,AI报告说:
开头出现 FF FE 3C,说明这个文件是 UTF-16 小端序(UTF-16 LE)编码的 HTML,3C 是 < 的 UTF-16 小端字节表示(3C 00 的前两个字节)。
FF FE 是 UTF-16 小端序的 BOM(字节顺序标记),3C 是 < 的十六进制 ASCII 码,所以 FF FE 3C 实际对应文本内容就是 <(后续应该跟着 00 构成完整的 UTF-16 字符)。
HTML开头出现FF FE 3C大概率会直接影响搜索引擎收录,严重时会导致页面乱码、爬虫识别失败,甚至出现索引大幅下降的情况。
但我想到新网页有时候还能搜索到,用的编辑器DreamWeaver里一直是UTF-8,新网页和旧网页用的编码风格一样的,不可能有这样明显的漏洞吧。
然后就安装了另外一个十六进制查看软件,发现没有FF FE 3C。如下图:
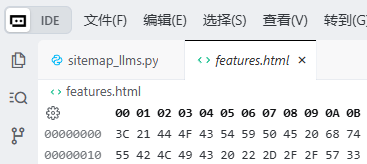
后来从各个渠道找资料,确定是旧UltraEdit32版本在显示数据时,自己组织成UTF-16 小端序模式来显示,并不是实际文件数据的体现。
在AI对话中提供错误数据的后果就是得到错误的结果,是一种AI幻觉,但责任不在AI方。AI后续给的建议要浪费更多时间和精力,要整个网站的文件都查一遍,统一整改,如果不小心可能会再改出更多问题。
AI的能力越全面,方向错了,伤害也就更大,所以用此事给大家提醒, 自己错误也会导致AI幻觉,使用AI要小心。