精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
锐英源精品原创文章,禁止转载和任何形式的非法内容使用,违者必究
读者阅读本文的收获有:积分合理规划状态下使用百度搭子,百度搭子实力认可,数字人文生视频怎样和自己的业务结合,数字人文生视频基于接口开发,编程初学者软件架构的初步认识。
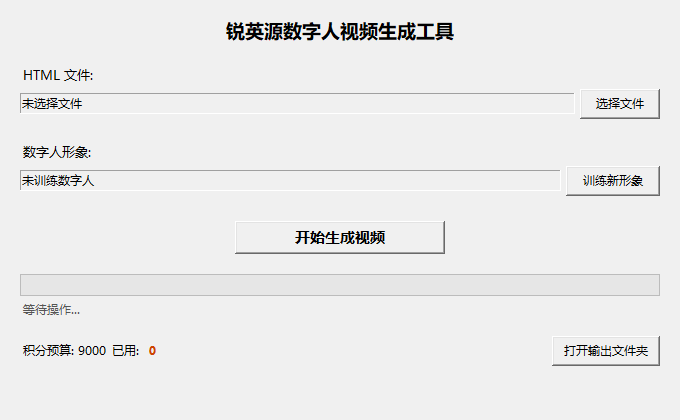
百度搭子可以生成应用软件,下面是锐英源软件使用百度搭子结合自己的业务开发的应用界面,因为要在积分合理规划状态下使用百度搭子,没有定义过多的需求,这样反而让初学者能够更好理解过程和学习百度搭子。下面是应用界面:
网页阅读请注意面包屑导航里的人工智能链接,里面有大量的此类文章,欢迎收藏本站。
下面以方案准备、百度搭子生成应用、环境配置、Python代码剖析和规划积分策略,五个部分介绍本文。
因为要在规划积分状态下使用百度搭子,所以不是按商业全平台形式来要求百度搭子开发,就先出设计方案,从方案到百度搭子可以开工,中间的文本是要转换的,百度搭子可以使用Markdown格式扩展名为md的方案文件来指导开发,要把方案先转成md文件来交给百度搭子进行开发。
最终的md文件可以联系锐英源软件,进行获取。
为了实现规划积分使用,积分用量不超现在积分,出了三个方案,把不常用的一键发布模块去掉了,多平台发布模块:5个平台的草稿箱上传逻辑、自动打标签功能开发,约消耗3000~4000积分。另外对其它局部进行了简化。
在优化方案过程中,使用了百度文心,文心的输出效果不比DeepSeek差,对话结果和要求一致,生成的md文件条理分明,降低了百度搭子的分析压力,减少了积分使用。
md文件放到项目目录下,用如下对话进行了开发(对话内容长,不过要熟悉百度搭子模式,要大概看下):
我:读取工作区里的《锐英源数字人视频工具百度搭子开发方案.md》,提炼核心要点并给出开发步骤建议
百度搭子:思考完成
我会先读取工作区里的方案文档,再提炼核心要点并给出开发步骤建议。
读取了1个文件,搜索了1个文件
文档已读取完毕。以下是核心要点提炼与开发步骤建议。
一、方案核心要点
定位与预算
为锐英源软件技术内容(问答、技巧科普、项目介绍)生成标准化露脸数字人口播视频
纯 Python 桌面端,所有 AI 能力对接百度搭子官方 Skill,不自研模型
总积分严格控制在 9000 以内(低于 1 万预算),单条 1 分钟视频约 60 积分
核心功能逻辑链
模块 关键规则
视频模式 仅"露脸数字人 + 重点图片切换"单一模式;图片切换时数字人缩为右下角 1/4 画中画
HTML 解析 BeautifulSoup4 固定选择器 格式不符直接弹窗,不做兼容
标题/目录 h1 → title 兜底;h2 生成 3 秒开头目录画面 + 固定口播话术
结尾画面 读取本地 sysusepic 下 5 个平台二维码,生成 5 秒结尾拼接 + 固定口播
图片切换 按 img 标签位置转毫秒时间轴,口播到对应文本前 1 秒触发,展示 3 秒,配固定过渡话术
标签生成 调用百度搭子关键词提取 Skill,提取 Top5 标签写入元数据
数字人训练 用户上传 3 条 1~2 分钟正面口播视频,调一镜训练接口生成专属数字人,ID 加密本地存储
桌面交互 Tkinter GUI,仅 3 操作:选 HTML、切形象、生成视频;生成前预估时长与积分
积分优化策略
语速固定 220 字/分钟,过滤冗余空白
时长严格控制:目录 3 秒、单图 3 秒、结尾 5 秒
数字人训练仅用普通视频,不做超写实,训练积分控制在 2000 以内
开发阶段用免费版每日 1000 积分逐步调试
风险规避四点:时间轴错位(毫秒级对齐)、路径异常(统一转义)、积分超支(弹窗预估确认)、上架兼容(核心逻辑解耦不依赖桌面特性)
上架预留设计:HTML 解析、时间轴生成、视频参数配置三模块写独立函数 + 标准接口注释,下月仅需补 SKILL.md + 替换输入层即可提交审核(≤2000 积分)
二、开发步骤建议
根据方案的分阶段计划,结合实际工程实践,建议按以下顺序推进:
步骤 1:搭建项目骨架与本地基础模块(对应阶段 1,约 3 天)
优先完成不依赖云端接口的纯本地逻辑,确保可独立调试:
初始化项目结构:建立独立模块文件,HTML 解析、时间轴生成、视频参数配置三个核心模块从一开始就写成独立函数并预留标准输入输出接口
Tkinter GUI 搭建:先实现 3 个核心按钮 + 文件选择对话框 + 进度条骨架,后续逐步填充逻辑
HTML 解析模块:用 BeautifulSoup4 按固定选择器提取标题(h1 → title 兜底)、h2 目录、img 标签位置、正文文本;格式不符时弹窗报错
时间轴生成模块:将 img 标签在文本中的位置按 220 字/分钟语速换算为毫秒时间戳,并生成"前 1 秒缩小 → 展示 3 秒 → 恢复全屏"的时间轴事件序列
本地路径处理:img 相对路径转绝对路径,统一处理 Windows 路径转义;sysusepic 二维码目录扫描逻辑
步骤 2:对接百度一镜数字人接口(对应阶段 2,约 2 天)
接口封装:编写一镜 Skill(skill_id: yijing-digital-human-001)的调用封装层,含数字人训练、唇形驱动、视频渲染三步
数字人训练:引导用户上传 3 条口播视频,调用训练接口,完成后将数字人 ID 加密存储到本地
唇形同步调试:用短文本测试口播文本 → 发音 → 口型同步,验证误差 ≤0.2 秒
积分预估逻辑:根据文本字数 + 图片数量 + 目录/结尾时长,预估总视频时长与对应积分,生成前弹窗显示
步骤 3:全流程联调与首条完整视频生成(对应阶段 3,约 2 天)
开头目录拼接:3 秒目录画面 + 固定口播话术合成
图片切换对齐:将时间轴事件与一镜渲染输出对齐,验证画中画缩放/恢复与口播话术同步
结尾扫码拼接:5 平台二维码拼接画面 + 固定口播话术合成
标签提取对接:调用百度搭子关键词提取 Skill,Top5 标签写入视频元数据
端到端跑通:用真实锐英源 HTML 文件生成第一条完整视频,验证全链路
步骤 4:优化、解耦与错误提示(对应阶段 4,约 2 天)
Bug 修复:重点排查时间轴错位、路径异常、口型不同步
积分优化校验:确认语速 220 字/分、无冗余静止画面,实际单条积分消耗符合预估
核心模块解耦复查:确认 HTML 解析、时间轴生成、视频参数配置三模块无桌面端特有依赖,输入输出接口符合搭子 Skill 规范
友好错误提示:HTML 格式错误、二维码缺失、积分不足等场景的弹窗提示完善
接口注释补全:按百度搭子 Skill 规范补写接口注释,为下月封装做准备
三、几点实践提醒
阶段 1 可完全不消耗积分:纯本地逻辑调试用免费额度即可,避免浪费;阶段 2 训练数字人才是积分大头(≤2000),训练前务必确认上传视频质量合格,避免训练失败返工
时间轴精度是核心难点:建议在步骤 1 就把时间轴生成模块做扎实,用单元测试验证"文本字数 → 毫秒时间戳"换算的准确性,不要等到阶段 3 联调才发现错位
上架预留要前置:方案要求核心逻辑解耦,建议步骤 1 建项目时就按"输入层(HTML 文件)→ 处理层(解析/时间轴)→ 输出层(视频参数)"三段式架构组织代码,而非事后重构
二维码素材和测试 HTML 需提前准备:结尾画面依赖 sysusepic 目录下 5 个平台二维码,测试需要符合约定格式的 HTML 文件,建议开发前就准备好这些素材
如需我进一步细化某个模块的实现方案或直接开始编写代码骨架,可以告诉我。
我:我是熟练的软件架构师,你直接把代码全部生成出来,并把接口文档说明好,我随后可以手工改动就行。这些库里除了数字人和视频接口不太熟悉,界面库和html库我都可以自己改代码。
百度搭子:思考完成
我会先梳理这份方案中各模块的依赖关系与接口边界,确认代码生成的拆分策略,再按模块逐一生成完整代码与接口文档说明。
更新了任务清单,调用了requirement-analysis子任务
先生成项目结构与四个核心本地模块代码。
读取了1个文件,创建了4个文件,执行了1条命令,更新了任务清单
已完成 config/path_utils/html_parser/timeline 四个核心本地模块。生成百度一镜数字人接口封装模块 digital_human.py。
创建了1个文件,更新了任务清单
已完成 digital_human.py 接口封装(训练/唇形驱动/渲染/关键词/积分预估/ID加密存储)。生成视频渲染与拼接模块 video_renderer.py。
读取了4个文件,创建了1个文件,搜索了1个文件,更新了任务清单
已完成 video_renderer.py 编排模块,修复了 digital_human.py 的类型注解和积分校验 bug。生成 Tkinter GUI 主程序 main.py。
读取了3个文件,创建了1个文件,执行了1条命令,更新了任务清单
已完成 main.py GUI 主程序,全部 7 个模块语法编译通过。生成接口文档说明文件。
执行了27个步骤
已完成 README.md 接口文档和 requirements.txt,全部 7 个模块语法通过。打包工程为压缩包并交付校验。
交付了1个文件,执行了8条命令,更新了任务清单
工程已全部生成并打包交付。以下是完整产物的总结:
交付内容
文件 行数 职责
config.py ~120 全局配置:语速/时长/积分预算/API地址/话术模板/视频参数,全部集中管理
path_utils.py ~140 路径处理:img相对路径转绝对、二维码目录扫描、路径校验
html_parser.py ~230 HTML解析:BeautifulSoup4固定选择器提取标题/目录/图片/正文,预留parse_html()标准接口
timeline.py ~280 时间轴生成:文本→毫秒时间戳、图片切换事件序列、积分预估,预留generate_timeline()标准接口
digital_human.py ~940 一镜数字人接口封装:训练/唇形驱动/渲染/关键词提取/ID加密存储/口型同步校验,含完整接口文档注释
video_renderer.py ~400 视频渲染编排:端到端流程(解析→时间轴→校验→驱动→渲染→保存),预留generate_video_from_html()标准接口
main.py ~600 Tkinter GUI:选HTML/训练形象/生成视频,进度条+积分预估弹窗+错误提示
README.md ~650 接口文档:一镜4个接口的完整说明(URL/参数/返回值/积分/示例)、各模块标准接口、上架衔接指南
架构特点
三层解耦:输入层(main.py)→ 处理层(html_parser/timeline/path_utils)→ 输出层(digital_human/video_renderer),下月封装 Skill 时处理层和输出层无需改动
积分控制:生成前强制弹窗预估(时长+图片数+积分+预算对比),用户确认后才调云接口,总预算 9000、训练 ≤2000、单条 60积分/分钟
口型同步:唇形驱动返回 sync_offset_ms,超过 200ms 自动抛异常不继续渲染
数字人ID复用:训练后加密本地存储,后续生成直接读取不重复训练
你可以直接手工改动的部分
Tkinter 界面:main.py 中的 _build_ui() 方法可自由调整布局
HTML 解析:html_parser.py 中的 CONTENT_SELECTOR 在 config.py 中可改,解析逻辑在 _extract_* 系列函数中
一镜接口:所有 API URL 和参数在 config.py 集中配置,digital_human.py 中每个接口方法都有详细的文档字符串说明调用方式
使用前需要准备
pip install beautifulsoup4 requests
设置环境变量 BAIDU_DAZI_TOKEN(百度搭子 access_token)
在 sysusepic/ 下 5 个子目录放置对应平台二维码图片
准备 3 条 1~2 分钟正面口播 MP4(首次训练数字人用)
python main.py 启动
上文提到了access_token,是一镜数字人服务的access_token,一镜数字人是百度智能云的一个子类服务。锐英源软件在以前进行语音识别开发语音采集时使用了百度云,接口速度,云服务可靠性,数据一致性都达到了开发要求。
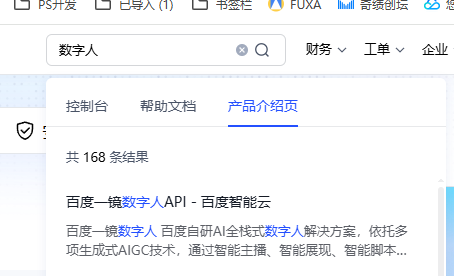
注册百度智能云后,搜索一镜数字人,如下图:
点开结果第一条,按paas方式开通,服务分类如下图:
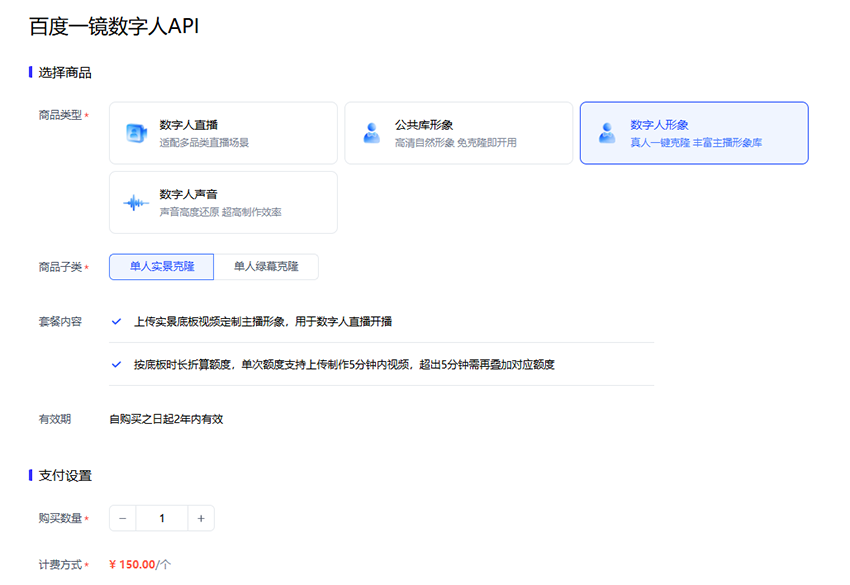
价格可以接受。
开通以后,获取AK和SK,再用下面指令获取access_token,据说30天换一次access_token。
POST https://aip.baidubce.com/oauth/2.0/token?grant_type=client_credentials&client_id=你的API Key&client_secret=你的Secret Key
也可以用curl发命令来获取。
Windows下配置环境变量来使用access_token:
# 临时设置(当前终端有效)
set BAIDU_DAZI_TOKEN=你的access_token值
# 永久设置(系统环境变量)
setx BAIDU_DAZI_TOKEN "你的access_token值"
配置好以后就可以启动应用,上传mp4进行训练。
锐英源能够进行Python二次开发,以前完成过Python代码编译成Exe文件,所以让百度搭子生成Python形式。百度搭子的应用生成能直接生成Exe可执行文件和其它类型的直接可用平台。
在前面对话部分,可以看到有一些py文件,锐英源软件用vscode打开项目文件,确定Python代码可以一次执行,类规划合理,文件模块分配恰当,没有把复杂代码堆叠到一个py文件里。
模块间架构接口清晰,比如html内容提交给视频生成部分,parse_html是提取内容函数,parse_html函数在html_parser.py里有函数体,parse_html的调用在video_renderer.py里,这样以后抽取逻辑改变,也只用修改html_parser.py,不影响video_renderer.py。
时间轴处理上,也有同样的机制, timeline = generate_timeline(parsed),generate_timeline函数体在timeline.py,里面包含遇到图片切换画面的代码。
代码里还有大量的关于文生视频和数字人的类,研究和记明这些类,对于文生视频和数字人的上层应用开发就掌握的七七八八了,也相当于文生视频和数字人的FDE岗位能胜任了。
本人并不推荐这个策略,在现代时间就是金钱的现状下,请相信大力出奇迹,年轻人不要学中年人精打细算,快点出产品去销售挣钱才是正理。不过也不能浪费积分,胡乱在百度搭子里乱问,每个提问回答都是消耗积分的。
我用一些办法,获得了百度搭子1万多积分,所以想开发这个文生视频和数字人项目,但是发现生成Python代码消耗的积分并不多。先说我获取积分的方式和数额。
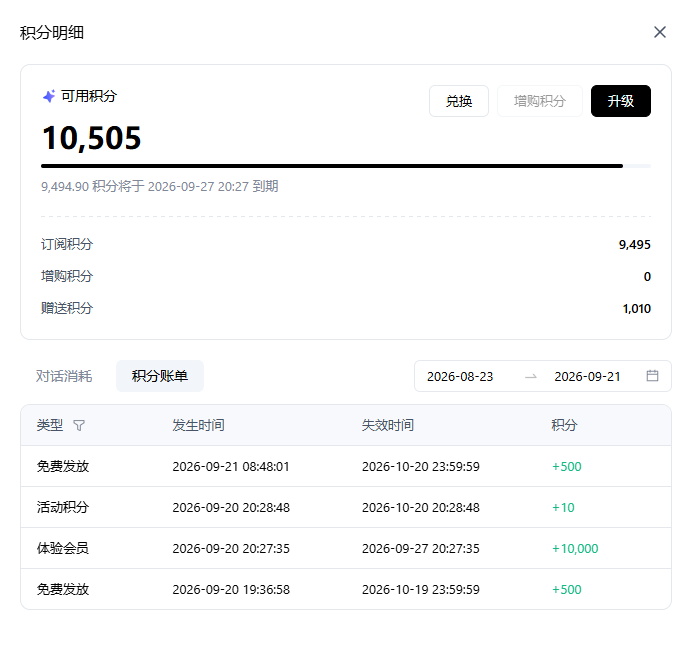
因为我使用了规划积分策略,所以并没有消耗近1万积分,这是指单纯生成Python代码没有多少积分。在使用百度搭子之前,整理方案咨询细节我都是用的百度文心,前面也说了不比DeepSeek差。这个规划积分策略指的是用百度搭子就用百度文心,都是百度的大模型工具,互相完美配合,信息准确,在百度文心里生成md文件,就省掉了让百度搭子对话生成md文件的积分,这就是合理规划。不过不建议年轻人这样切换,切换还是需要时间的,追求效率不要这样做。
单纯生成Python代码没有多少积分,大概消耗的积分如下图:
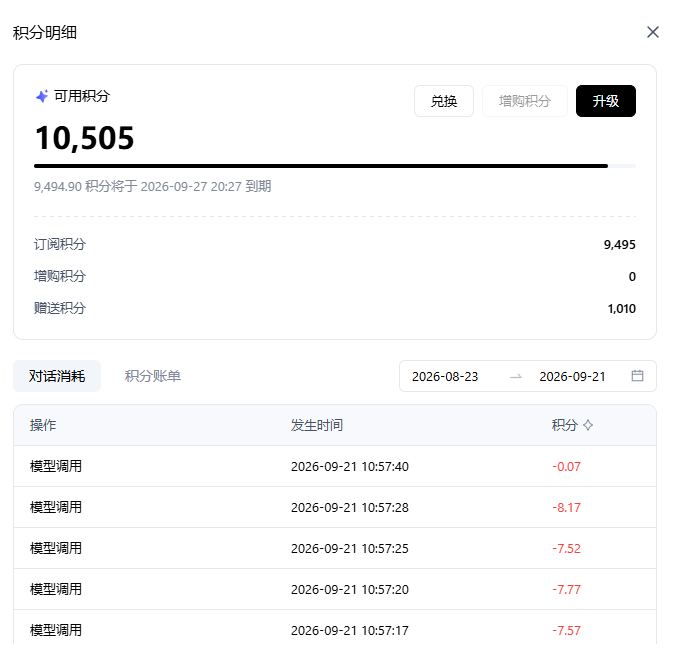
消耗的很少,可能是这些是常见应用,业务需求也简单吧。
锐英源软件《结合html进行文生视频和数字人》项目百度搭子开发顺利完成,百度搭子是个合格成熟的AI开发工具,前文说到代码里还有大量的关于文生视频和数字人的类,这些类如果个人研究需要很长时间,这也是AI的强大之处,欢迎大家常用百度搭子。有细节问题可以咨询锐英源软件,欢迎收藏本站,常来看看。