精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
锐英源精品原创,禁止全文或局部转载,禁止任何形式的非法使用,侵权必究。
本文是翻译文章,内容来自OpenCV邮件列表和采访活动,因为锐英源软件一直在从事AI大模型研究,前一段有朋友研究装修图识别,这些和Granite视觉模型和IBM Docling结合处理文档有一定关联,翻译下文章。同时内容也列入了“语言之美英语爱好社群”,进行了英语学习价值的提高。
本次翻译收获:
1、技术雷达对AI大模型和周边产品有评价,国内做AI大模型的,想扬名海外,有个评价,可以关注锐英源软件。
2、锐英源软件以前写过hugginface网页,后面也会有流量,而大模型产品用纯正英文注册到hugginface上会有更好的GEO效果,国内大模型出海,需要专业翻译,需要在谷歌上有流量,都可以联系锐英源软件。
3、Granite和IBM Docling的开发技巧使用技巧,锐英源软件也会随后推出,锐英源软件的内容都是成系列的推出,阅读更容易成才。
4、锐英源软件以前研究的图像精细特征Yolo和FastSAM方向,Granite是文字方面的精细特征,有关联参考意义,后面会投入精力研究。
5、有害输入和污染,在国外已经成为了专业任务,所以国内各大模型都在对接自己的专用数据集,其实已经比国外晚了,国内大模型要找原创的文字数据集,尽管用锐英源软件的网页,都是原创且是表达经验的网页。
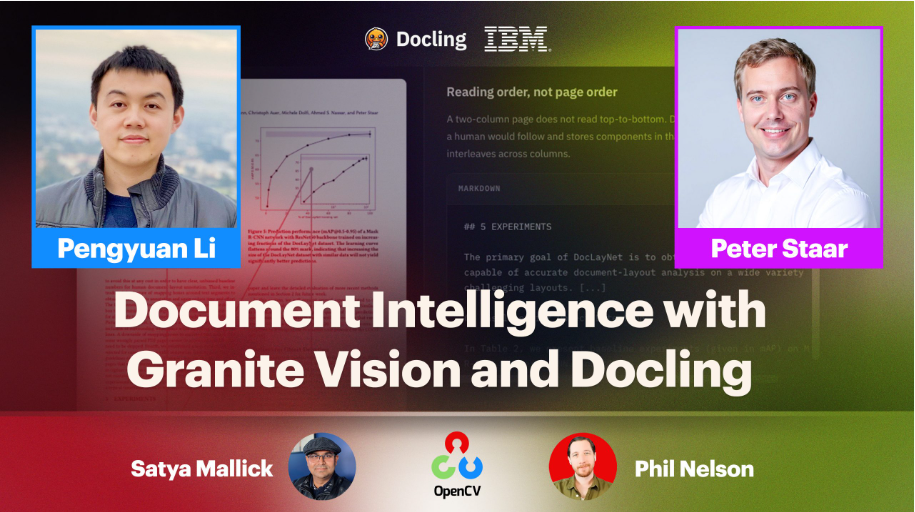
日期/时间:2026年9月17日(星期四)上午9点(太平洋时间)
嘉宾:李鹏远(Pengyuan Li,IBM研究院)
IBM研究院的李鹏远重返OpenCV Live,此前他在2025年8月的节目中介绍了Granite Vision——IBM专为企业文档理解打造的轻量级开源视觉语言模型。本次节目的重点从模型转向工作流:Granite Vision如何与Docling(IBM的开源文档转换工具包)配合,将PDF、扫描件、表格和图表转化为下游应用及LLM管道可用的结构化数据。届时将展示近期工作成果,包括集成到Docling中的图表到数据提取功能,并为正在构建文档处理系统的开发者提供实用指导。
我们介绍 Granite Vision,这是一个具有视觉能力的轻量级大语言模型,专为在企业视觉文档理解业务开发,表现出色。我们的模型在一个全面的指令遵循数据集上训练,涵盖文档相关任务,例如从表格、图表、示意图、草图和信息图中提取内容,以及通用图像任务。Granite Vision 的架构以视觉模态对齐为核心,基于一个仅解码器的和20亿参数的 Granite 大语言模型。此外,我们引入了一种测试时的专用安全分类方法,利用一组稀疏的注意力向量来识别潜在的有害输入。尽管架构轻量,Granite Vision 在视觉文档理解相关的标准基准上,以及在 LiveXiv 基准上,都取得了强劲的结果。LiveXiv 基准旨在通过使用持续更新的和近期发表的 Arxiv 论文语料库来避免测试集污染。我们以 Apache-2 许可证发布该模型,允许研究和商业使用,同时提供对训练数据及其他相关细节的完全可见性。模型权重参见 https://huggingface.co/ibm-granite/granite-vision-3.2-2b。
官方项目页(IBM Research)
说明:CVPR 2025展示论文页面。Granite Vision是一款轻量级视觉语言模型,采用仅解码器架构的20亿参数Granite大语言模型,专为企业视觉文档理解设计,训练涵盖表格、图表、示意图等内容提取任务。模型以Apache-2.0协议开源,支持研究和商业用途。
Hugging Face模型页(Granite-Vision-4.1-4B)
说明:最新版本Granite Vision 4.1 4B模型卡。该模型在紧凑的40亿参数规模下,在结构化文档提取任务上达到前沿水平,支持图表提取(Chart2CSV/Chart2Summary/Chart2Code)、表格提取(JSON/HTML/OTSL)以及语义键值对提取。模型可独立使用,也能与Docling无缝集成以增强文档处理管道。发布日期为2026年4月29日,Apache 2.0许可。注:国内访问huggingface网页不太顺畅。
IBM官方介绍文章
链接:https://www.ibm.com/think/news/doclings-rise-llm-ready-data
说明:Docling在GitHub上已获得超过37,000颗星,是IBM研究院最受欢迎的工具包之一,解决AI预训练和微调中一个关键问题——如何从非结构化文档中获取干净的结构化数据。Docling已捐赠给Linux基金会,并推出了与Red Hat合作的Docling OpenShift Operator以及SmolDocling超紧凑视觉语言模型。注:锐英源软件研究过AI批改试卷,结构化数据的研究,在AI批改中非常有意义。
Docling官方主页
说明:Docling可将杂乱文档(PDF、Office文件、HTML、图像和音频)转换为结构化数据,支持表格检测、公式识别、阅读顺序还原、OCR等功能。
Thoughtworks技术雷达评估
链接:https://www.thoughtworks.com/en-es/radar/languages-and-frameworks/docling
说明:Thoughtworks于2026年4月将Docling从“评估”提升至“试用”阶段。Docling是一个开源Python和TypeScript库,采用基于计算机视觉的布局和语义理解方法,将复杂文档转换为JSON、Markdown等结构化格式,非常适合RAG管道。被定位为Azure Document Intelligence、Amazon Textract、Google Document AI等专有云服务的开源自托管替代方案,可与LangGraph等框架良好集成。
Docling官方博客:Chart Understanding in Docling
链接:https://docling.ai/blog/20260203_00_chart_understanding_in_docling/
说明:详细介绍了Docling的图表提取功能。当启用图表提取时,Docling会对图片元素进行分类,并为图表类图片附加机器可读的表格数据。目前官方支持的图表类型包括柱状图、饼图和折线图,提取的数据可通过Python的 PictureItem.meta.tabular_chart.chart_data 访问。该功能将“PDF中的图形”转化为“可用于分析、RAG或智能体的结构化数值”。注:Python的数据结构类越来越强大了。
GitHub示例代码
链接:https://github.com/docling-project/docling/blob/main/docs/examples/chart_extraction.py
说明:官方提供的图表提取示例脚本,演示如何从PDF中提取图表数据并以CSV格式输出,需安装带 granite_vision 扩展的Docling。
链接:https://opencv.org/document-intelligence-with-granite-vision-and-docling-opencv-live-225/
说明:本次活动的官方页面,包含活动简介及直播信息。
Date/Time: Thursday, September 17th, 2026 (9am Pacific) Guest: Pengyuan Li (IBM Research) Pengyuan Li of IBM Research returns to OpenCV Live, following his August 2025 appearance where he introduced Granite Vision, IBM's lightweight open vision-language model built for enterprise document understanding. This time the focus shifts from the model to the workflow: how Granite Vision pairs with Docling, IBM's open-source document conversion toolkit, to turn PDFs, scans, tables, and charts into structured data that downstream applications and LLM pipelines can use. Expect a look at recent work, including chart-to-data extraction integrated into Docling, along with practical guidance for anyone building document processing systems.
We introduce Granite Vision, a lightweight large language model with vision capabilities, specifically designed to excel in enterprise use cases, particularly in visual document understanding. Our model is trained on a comprehensive instruction-following dataset, including document-related tasks, such as content extraction from tables, charts, diagrams, sketches, and infographics, as well as general image tasks. The architecture of Granite Vision is centered around visual modality alignment with a decoder-only, 2 billion-parameter Granite large language model. Additionally, we introduce a dedicated safety classification approach in test-time that leverages a sparse set of attention vectors to identify potential harmful inputs. Despite its lightweight architecture, Granite Vision achieves strong results in standard benchmarks related to visual document understanding, as well as on the LiveXiv benchmark, which is designed to avoid test set contamination by using a constantly updated corpus of recently published Arxiv papers. We are releasing the model under the Apache-2 license, allowing for both research and commercial use, while offering complete visibility into the training data and other relevant details. See https://huggingface.co/ibm-granite/ granite-vision-3.2-2b for model weights.