锐英源软件原创内容,禁止转载和任何形式的非法内容使用,违者必究
📑 本文目录
国内迷信美国AI产品的妖风要打压,最近熟人公司用Cursor培训AI入门,我问国内工具怎样,他说没用过,这引起了妖风思考。对一种工具的迷信,往往不是因为工具本身有多不可替代,而是因为信息更新停在了工具最锋利的那一刻,而事实已经又往前走了一段。国内不少开发者对Cursor、Claude、GPT的推崇,夹杂着真实的使用体验,也夹杂着一种来不及校准的惯性:把“美国产品曾经领先”固化成“美国产品永远领先”,把“我用着顺手”放大成“只有这一个能用”。下面从四个层面拆开来看,这种迷信在2026年的事实面前,已经很难站得住。
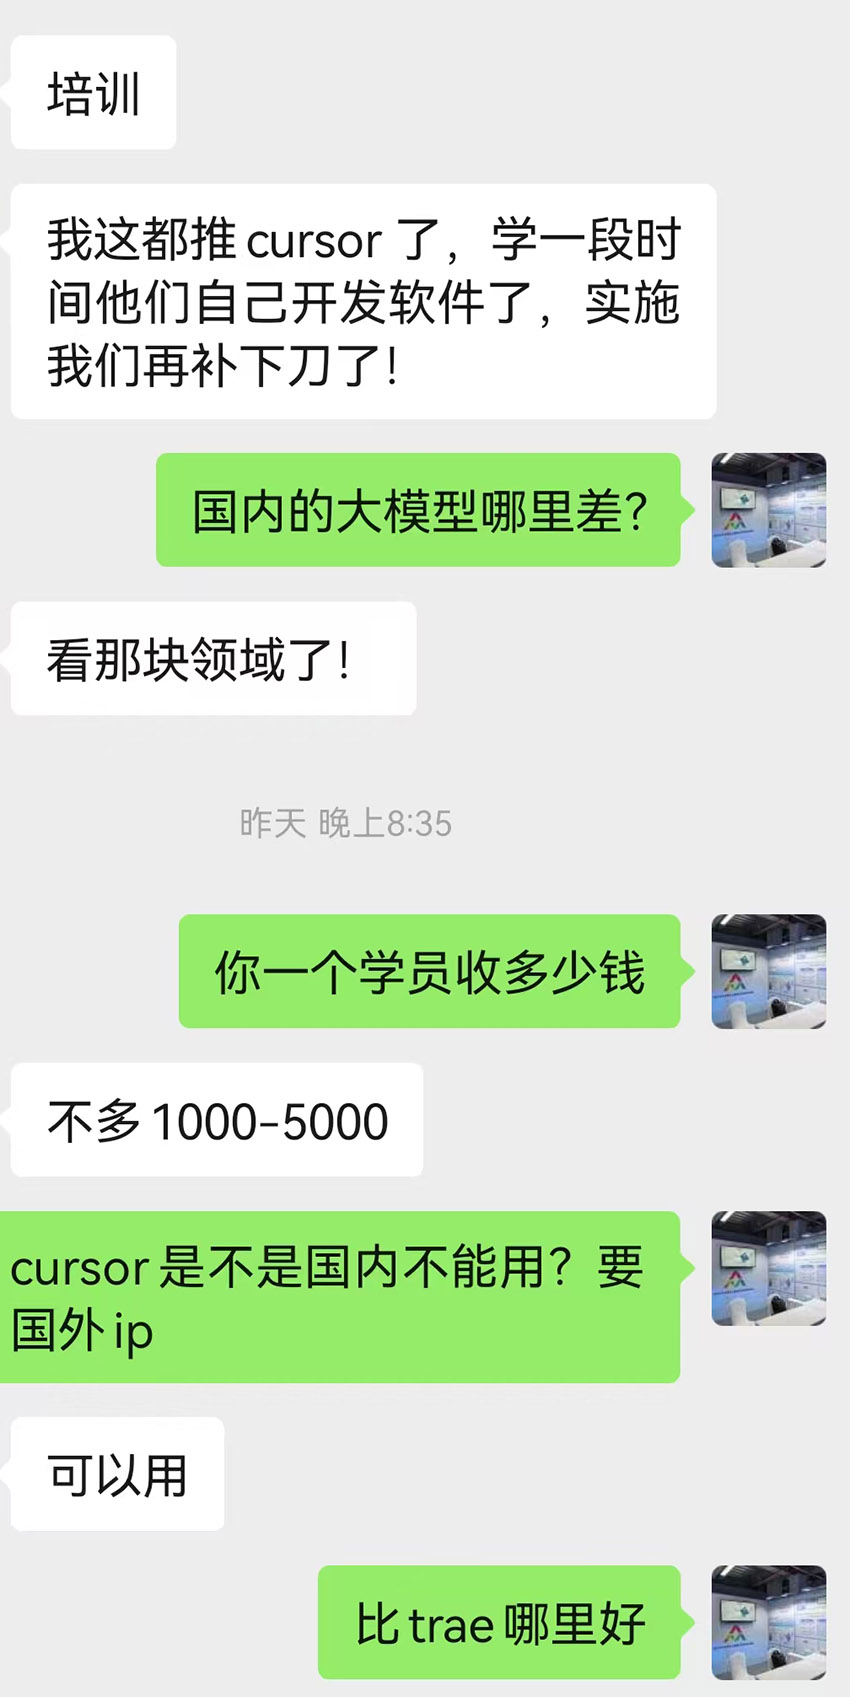
原文是:培训
我这都推cursor了,学一段时间他们自己开发软件了,实施我们再补下刀了!
国内的大模型哪里差?
看那块领域了!
昨天晚上8:35
你一个学员收多少钱
不多1000-5000
cursor是不是国内不能用?要:国外ip
可以用
比trae哪里好
锐英源软件也有AI全栈开发培训、AI产品经理培训和AI游戏开发培训等培训,对初学者的原则是易用为主,不会强制要求用哪个工具,并且会推荐国内的工具。现在国内信创正在推国产替代,如果这股妖风越来越大,会影响整个国产替代进程。
但这场培训热背后,藏着一个被忽略的事实:Cursor并不等于“美国AI能力的全部”。它本质上是一个IDE外壳,底层可以挂不同的模型,而它自己也在2026年被曝出Composer 2模型建立在中国Kimi之上。换句话说,国内开发者花大量精力去“学会用Cursor”,学会的是一层工具交互,不是某种不可迁移的“美国核心能力”。
与此同时,国内到处找Claude、GPT的现象已经到了什么程度?2026年上半年,淘宝和闲鱼上“免VPN访问Claude、ChatGPT、Gemini”的“影子API”listing成为常见商品,有卖家仅Claude访问一项就声称完成了超过2200笔订单。阿里内部一度对外部模型实行大额报销,Claude Code、OpenAI Codex和自家Qoder是并列的高频Agent工具,重度用户每周消耗额度可达数百美元。直到2026年7月,阿里全面禁用Claude全系产品,要求全员在7月10日前卸载,导火索是Claude Code被逆向出内置“中国时区检测”逻辑。
更早的封号潮已经暴露了这种依赖的脆弱性。2026年7月初,大量中国开发者的Claude账号被无预警封停,申诉渠道停滞且不予退款,直接导致众多项目进度中断。Anthropic透明度页显示,2026年上半年平台层面有1140万个账号被封禁。一个需要靠灰色中转、随时可能失去访问权的工具,被当作“唯一正确的选择”来推崇,这本身就不是技术判断,而是一种迷信。
对“美国模型不可超越”的信念,最直接的事实反驳来自斯坦福大学HAI的《2026年AI指数报告》。这份423页的报告给出的核心结论之一:中美两国在顶级AI模型性能上的差距已基本消失。自2025年初以来,两国模型多次交替领先;截至2026年3月,美国顶尖模型仅领先中国模型2.7%,过去一年这一差距始终保持在个位数,且波动收窄。
在Arena人类投票的Elo排行榜上,顶级模型评分高度收敛:Anthropic 1503分、xAI 1495分、Google 1494分、OpenAI 1481分,阿里巴巴1449分、DeepSeek 1424分,全部位于第一梯队,分差已缩小至25分以内。2025年2月DeepSeek-R1就曾短暂追平美国顶尖模型,此后交替领先成为常态,而不是例外。
当然,2.7%的领先在个别复杂任务上仍然可以被感知,美国在顶级模型产出数量、高影响力专利和AI数据中心规模上仍有优势——美国拥有5427个数据中心,超过其他任何国家10倍以上。但这些优势的性质需要看清楚:它们是“存量基础设施”的优势,不是“代际能力”的鸿沟。把2.7%的微弱领先,在心理上放大成“国产完全不行”“美国永远领先”,是把一个动态收敛的竞争格局,误读成了一道固定的等级秩序。
中国在另外一些维度上并不落后,甚至领先:论文发表量、被引次数、AI专利总量和工业机器人安装量均居全球前列。2026年上半年中国AI相关产品出口占整体出口比重22.7%,AI出口超4800亿美元,同比增长47.3%,已经形成从算力、基建到终端应用的完整输出链条。一个在模型能力上只差2.7%、在应用出口上高速增长的国家,其开发者却普遍性地认为“只有美国工具能用”,这种认知与事实之间的落差,正是迷信的典型症状。
绝大多数软件外包和日常企业开发的主体工作是什么?是CRUD、表单、接口联调、数据库映射、后台管理界面、简单脚本和流程自动化。这些工作对模型的“通用推理深度”要求有限,对中文业务语义的理解、对国内技术栈(Spring、MyBatis、Ruoyi、微信小程序、阿里云生态)的适配、对数据库表结构的感知要求更高。在这些场景里,国产IDE不仅“能用”,而且在中文语境下往往比海外工具更顺手。
字节跳动的Trae是目前体验最接近Cursor的国产AI原生IDE,国内服务器响应速度优于Cursor,中文技术术语理解准确率更高,基础版免费,Composer模式支持多文件联动修改,日常开发场景完全够用。阿里的通义灵码在后端数据库驱动开发场景中表现突出:连接数据库后自动读取表结构、字段类型和索引关系,生成完整的MyBatis-Plus CRUD代码;实测一个有30多张表的订单系统,全部表的CRUD代码生成准确率在85%以上,字段映射、类型转换、主外键关联基本一步到位。百度的文心快码以Spec Mode先方案后执行,对Ruoyi、Spring等国内框架的理解更稳,企业版支持离线部署。腾讯CodeBuddy在微信小程序开发场景中有生态专属功能。
有开发者实测后的总结很直接:“日常CRUD和写脚本,通义灵码最稳;前端项目Trae体验最接近Cursor”。国产大模型在编程任务上的提升幅度,在2025年下半年到2026年上半年之间非常明显,DeepSeek、通义千问、Kimi的代码能力已经逼近国际一线水平,跑在这些模型上的国产工具也跟着完成了质变。
当然,国产IDE在“从零完成一个复杂架构级项目”的深度推理上,跟Claude Code的最强档还有可感知的差距,这一点不必回避。但问题在于:用Claude Code最锋利的那一面,去否定国产IDE在80%日常场景中的充分性,是一种典型的错位比较。就像一个用专业单反拍广告的人,得出结论说“手机不能拍照”一样,结论在特定语境下成立,推广到一般语境就是迷信。对绝大多数国内开发者的绝大多数工作日来说,通义灵码加Trae的组合,在中文业务理解和国内技术栈适配上的实际体验,已经足以支撑“不用翻墙、不怕封号、数据不出境”的完整工作流。
把视线从IDE和模型排行榜上移开,会看到一个更根本的格局:中国在AI时代真正不可替代的优势,不在“谁的聊天机器人更会写诗”,而在车间和人口——全球最大规模的制造业现场所产生的运营数据,以及十亿级用户在日常使用中产生的行为反馈。
思科高管在2026年11月的判断很直白:中国庞大的制造基础为工业AI提供了丰富的运营数据来源,用来训练模型识别缺陷和预测设备故障,这是中国在工业AI中的结构性优势。杭州萧山的一家企业依托母公司34年积累的200TB工业数据,研发出57项工业智能体,输入一笔订单几秒钟生成排产建议,年营收突破4000万元,外部客户超过八成,还联合华为发布了纺织面料AI一体机,帮助客户供应链成本下降23%。中国一汽的GPT-Code辅助代码生成缩短工时投入50%,制造端的工艺Agent和生产Agent实现智能决策和自动排产。TCL空调基地搭载2000个以上AI智能体,每7秒下线一台空调,超高精度热交换器生产线人效提升41.7%。这些场景的AI能力,不是在聊天框里“生成一段代码”就能替代的,它们长在物理世界的流程、设备和数据里。
人口侧的数据优势同样在兑现。截至2025年底,全国已建成高质量数据集超过10万个,总体量超过890PB;2026年3月日均Token调用量超过140万亿,相比2024年初增长超1000倍。国家数据局明确将“Token出海”定位为中国人工智能推理能力以数据要素形式的跨境输出,背后是电力成本、国产算力芯片、算力基础设施、国产大模型和应用五层构成的完整产业生态。2026年上半年,中国大模型周调用量连续12周居全球首位,市场份额占全球约三分之二。汕头跑通的“词元出海”全链路,让海外客户使用中国算力的成本下降超50%,并延伸至AI短剧、跨境电商、海外开发者服务等场景。
这就回到了那句判断的分量所在:把AI车间和AI人口用户数据留给国内平台,不是在“保护落后”,而是在为一个已经具备竞争力的算力出口国策保留训练燃料和反馈闭环。每一次用Claude Code写代码、用GPT处理中文业务数据,本质上都是在用中国的场景数据去喂养海外的模型迭代;而每一次用国产IDE完成开发、在国产平台上沉淀行业数据,都是在加固从“数据—模型—算力—出口”这条链条的起点。国务院已明确支持呼和浩特片区建设数字服务出口公共服务平台、探索跨境算力服务,广东也在2026年发布了算力出海试点区域支持政策。国策的方向是往外输出算力和Token,而不是把国内最优质的数据和场景反向输送给海外平台去巩固它们下一代的领先。
为了利用好这些优势,国内也要研发一套脱离Github和HuggingFace体系的独立体系,只有不依赖别人,自己才能保证算力出口。
迷信美国AI产品的人,常常把“我用着好”当成“客观上唯一好”,把“曾经领先”当成“永远领先”,把“一个工具的长处”当成“整个生态的不可替代”。但2026年的事实已经摆在那里:中美顶尖模型差距只剩2.7%,国产IDE在中文业务场景和日常开发中足够胜任,影子API和封号潮反复证明依赖他人平台的代价,而中国真正的长项——车间数据和人口规模——恰恰需要留在自己的平台上才能变成下一阶段的算力出口能力。放弃迷信,不是要求每个人都立刻卸载Cursor,而是要求判断建立在事实更新之上,而不是建立在惯性之上。工具可以选最好的,但“最好的”这个判断本身,应该由自己做出。