锐英源精品原创文章,禁止转载和任何形式的非法内容使用,违者必究
Diffusers是扩散功能对应的Python库,Diff对应英语diffusion单词,因为扩散是图片、音频和分子三维前沿训练中必须要有的功能,所以Diffusers非常重要。Diffusers的功能结果和ComfyUI里的管线类似,但内在不一样。
Diffusers 官方对自己的定义是“模块化工具箱”(modular toolbox)。传统工具可能把模型、采样器、文本编码器焊死在一起,你只能用整套“套装”。Diffusers 把这些拆成独立的积木——UNet 是一块,Scheduler 是一块,VAE 是一块。你可以按说明书拼出标准套装(用现成的 Pipeline),也可以把 Scheduler 换成另一块,看看效果有什么不同。“拆开—替换—重组”,这三个词就是 Diffusers 的初学者友好版定义。
初学者不需要知道每个类的参数怎么传,只需要知道三块积木各自负责什么:
Pipeline:总装线。你把提示词交给它,它帮你走完整个流程,吐出图像。DiffusionPipeline.from_pretrained(...) 一行代码就能生成,这就是“套装拼法”。ComfyUI里的管线是可视化编辑的,只要懂一些术语和参数,就可以设计出管线,ComfyUI里能设计,学学Python环境,也就能用成Diffusers。
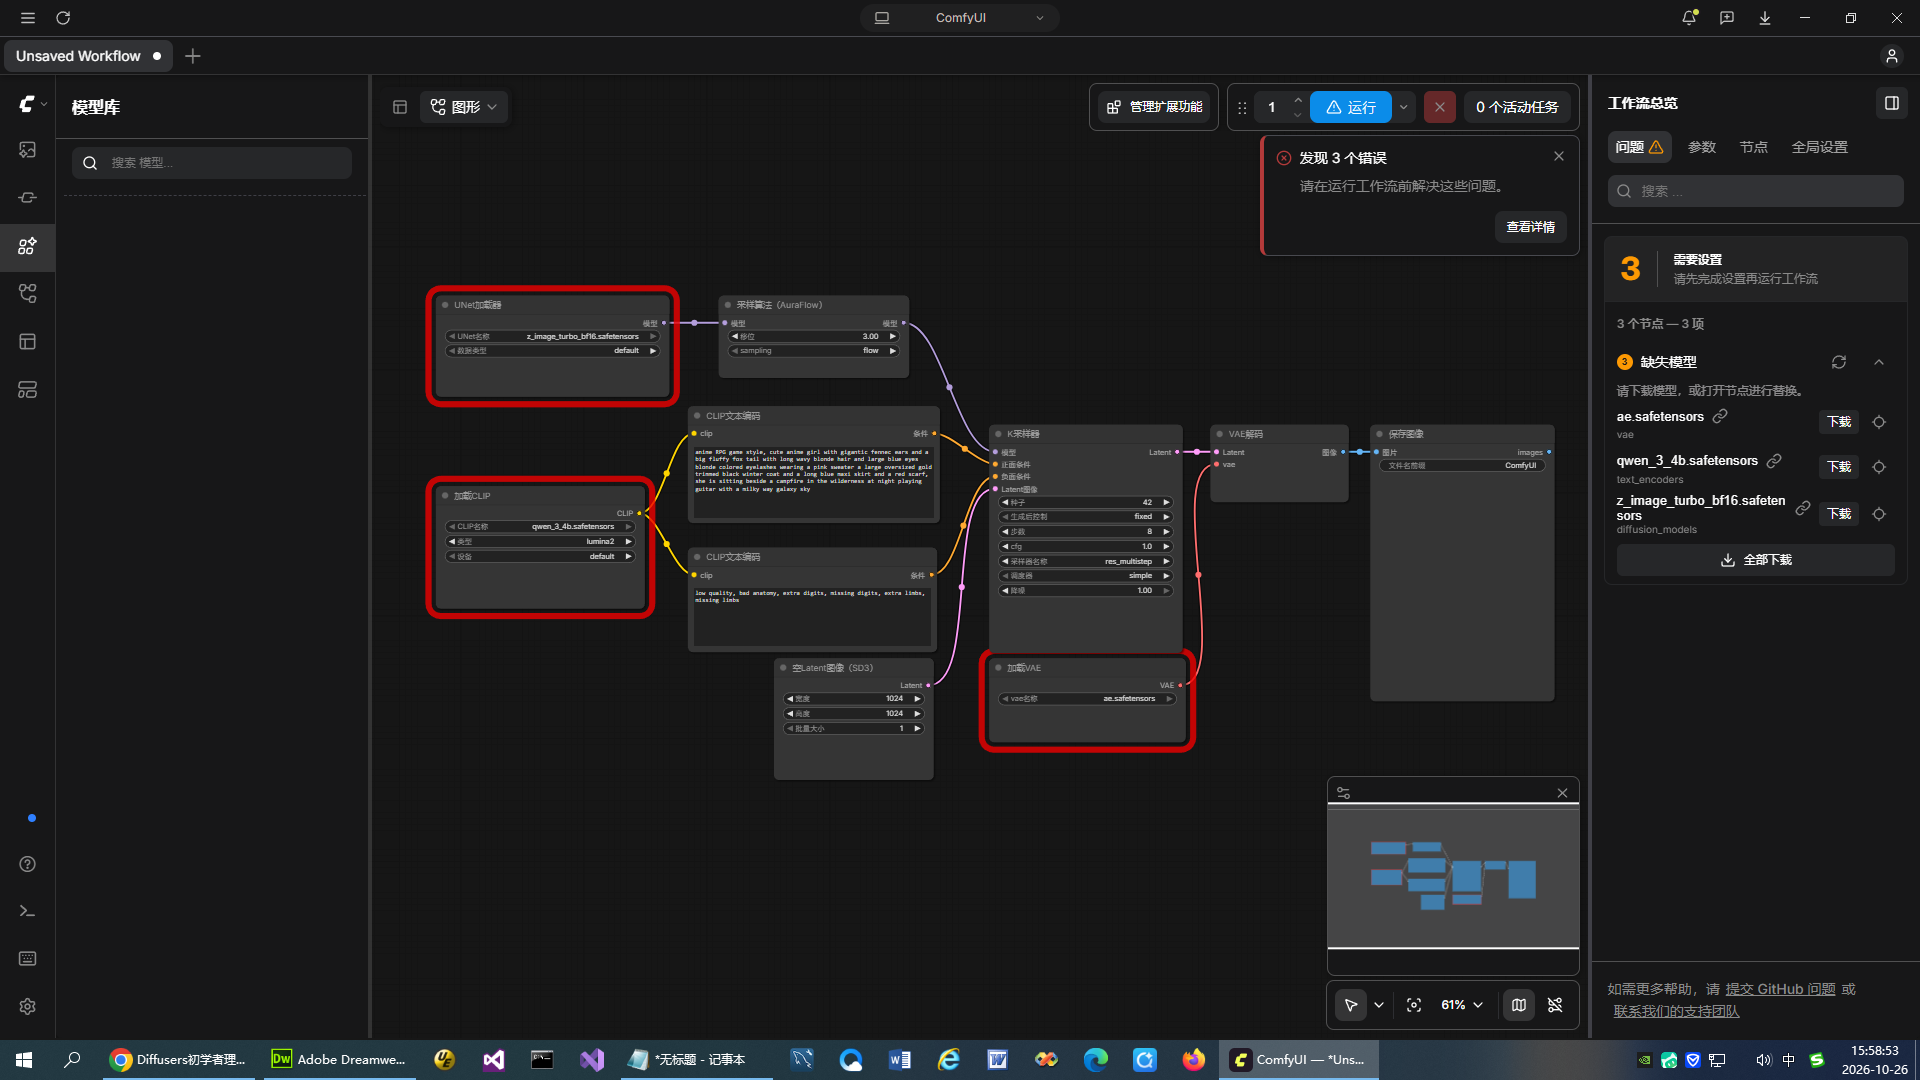
这是ComfyUI里的示意图,里面右侧模型里有diffustion,画板上右侧有VAE,本文下面会讲到。这种管线图会更直观理解数据从哪些AI大模型模块中进入出来,初学者只是看个热闹有这个意识,真正会操作还是要懂术语。
Model(UNet) :负责“猜噪声”。它看着当前那张模糊的图,判断里面哪里是噪声、噪声有多大。
Scheduler:负责“按步骤去掉噪声”。它拿到 UNet 猜出的噪声量,按照数学规则决定这一步该去掉多少,让图像清晰一点点。
用“总装线—质检员—节奏控制器” 来对应理解,初学者不需要任何数学背景就能理解三者如何协作。
VAE 的全称是 Variational Autoencoder,中文为变分自编码器。结合下面架构图就容易理解扩散和VAE。
VAE 就是 AI 生图流程里的“压缩包工具”。原图太大,AI 算不动,所以先用 VAE 把它压成一个“小抄”(潜变量)。AI 在这个“小抄”上反复修改、去噪,改好了之后,再用 VAE 把它“解压”回一张完整的大图。没有 VAE,扩散模型就得在巨大的原图上硬算,又慢又贵;有了 VAE,AI 只需要在一个小巧的潜空间里工作,效率和质量都能兼顾。
Diffusers 库可以理解为一个万能工具箱或标准接口:
统一调用方式:无论底层是哪个公司开发的扩散模型(图像、视频或音频),通过 diffusers 都只需几行标准代码就能加载和使用。这就像给所有电器提供了统一的插座,用户不用关心电器内部的电路有多复杂。
降低集成门槛:对于应用开发者来说,他们无需从零开始理解每个模型的代码,直接调用 diffusers 提供的“管道”(Pipeline)就能把AI生成能力集成到自己的软件里。这让新模型能快速被各类AIGC工具和工作流采用。
提供高级功能:除了基础生成,它还内置了LoRA微调、模型量化(让大模型在小显存设备上运行)、内存优化等高级功能,并且支持模块化的自定义流程。
所以,当一个新模型被 diffusers 库支持时,就意味着它已经被接入了AI生成领域最主流的生态系统,具备了被广泛使用的技术条件。
Diffusers是当前AIGC应用开发的基石性工具。 它的重要性体现在几个方面:
事实上的社区标准:它被描述为“调用各种主流文生图大模型的通用库”,已经成为“当今文生图大模型使用的社区标准”。
模型生态的核心枢纽:从腾讯的混元DiT到众多开源模型,都选择将其部署到 diffusers 库中,以便用户能用几行代码轻松调用。国内的研究机构(如深圳河套学院)和平台(如Gitee的模力方舟)也在围绕它进行模型适配和国产算力部署。
开发者的首选工具:它被定位为“生图领域最基础、最灵活的库”,非常适合快速原型设计、算法研究、LoRA微调和本地推理。
from diffusers import DDPMScheduler, UNet2DModel
from PIL import Image
import torch

scheduler = DDPMScheduler.from_pretrained("google/ddpm-cat-256")
model = UNet2DModel.from_pretrained("google/ddpm-cat-256").to("cuda")
scheduler.set_timesteps(50)

sample_size = model.config.sample_size
noise = torch.randn((1, 3, sample_size, sample_size), device="cuda")
input = noise

for t in scheduler.timesteps:
    with torch.no_grad():
        noisy_residual = model(input, t).sample
        prev_noisy_sample = scheduler.step(noisy_residual, t, input).prev_sample
        input = prev_noisy_sample

image = (input / 2 + 0.5).clamp(0, 1)
image = image.cpu().permute(0, 2, 3, 1).numpy()[0]
image = Image.fromarray((image * 255).round().astype("uint8"))
这段代码是 diffusers 库最经典的 “手动实现 Pipeline” 示例。它没有使用高层封装的 Pipeline,而是直接调用底层的 Model(UNet) 和 Scheduler,把上一轮聊到的“去噪循环”原理原原本本地写了出来。它的目标是:用 google/ddpm-cat-256 这个在猫脸数据集上训练的 DDPM 模型,从纯噪声生成一张 256×256 的猫图片。
这段代码也把diffusion功能,扩散洗练功能,表达的很清楚,在扩散过程中洗掉噪声,得到干净的照片。而噪声只是一种数据代表,掌握大模型的高手会把类似噪声的数据用这类过程处理掉。锐英源软件以前用的AI大模型识别,调用model()函数,返回复合数据结果,这里用了sample和prev_sample是更深层次的调用。
下面按执行顺序逐段解释。
    from diffusers import DDPMScheduler, UNet2DModel
    from PIL import Image
    import torch
    scheduler = DDPMScheduler.from_pretrained("google/ddpm-cat-256")
    model = UNet2DModel.from_pretrained("google/ddpm-cat-256").to("cuda")
DDPMScheduler.from_pretrained(...):从预训练仓库加载 调度器。它本身没有权重,加载的是 DDPM 的噪声调度参数(beta 序列等),决定了每一步该加/去多少噪声。
UNet2DModel.from_pretrained(...):加载 UNet 权重,这是真正负责“预测噪声”的神经网络。.to("cuda") 把它放到 GPU 上加速。
两者来自同一个仓库,保证调度参数与模型训练时一致——这正是 diffusers “模块可互换但需匹配”的体现。
scheduler.set_timesteps(50)
DDPM 原始训练用 1000 步,但推理时可以跳步加速。这里设为 50 步,scheduler.timesteps 会变成一个从大到小排列的时间步序列(如 980, 960, … , 20),循环就按这个序列走。
  sample_size = model.config.sample_size
  noise = torch.randn((1, 3, sample_size, sample_size), device="cuda")
  input = noise
model.config.sample_size 从模型配置里读出训练分辨率,这里是 256。
生成一个形状为 (1, 3, 256, 256) 的标准正态噪声:1 张图、3 通道(RGB)、256×256。这就是生成的起点。
input 既作为循环的当前样本,也作为下一步的输入被不断更新。
  for t in scheduler.timesteps:
        with torch.no_grad():
                  noisy_residual = model(input, t).sample
                  prev_noisy_sample = scheduler.step(noisy_residual, t, input).prev_sample
                  input = prev_noisy_sample
这是整段代码的心脏,每一步做两件事,正好对应 Model 预测 + Scheduler 更新:
model(input, t).sample:把当前带噪图像 input 和时间步 t 喂给 UNet,模型输出它认为图像里含有的噪声残差(noisy_residual)。注意 t 是标量张量,告诉模型“现在是第几步”,因为不同噪声等级下预测难度不同。
scheduler.step(noisy_residual, t, input).prev_sample:Scheduler 拿到“预测的噪声”和“当前样本”,按 DDPM 的数学公式计算出前一个时间步的样本(prev_sample),也就是噪声更少、更清晰的图像。
input = prev_noisy_sample:更新当前样本,进入下一轮。循环 50 次后,input 就从纯噪声变成了干净的潜变量(对 DDPM 而言就是像素空间图像)。
这三行初学者理解变量值交换,也容易理解旧新替换的目的。
torch.no_grad() 关闭梯度计算,因为只做推理,省显存、提速。
  image = (input / 2 + 0.5).clamp(0, 1)
  image = image.cpu().permute(0, 2, 3, 1).numpy()[0]
  image = Image.fromarray((image * 255).round().astype("uint8"))
input / 2 + 0.5:模型训练时图像被归一化到 [-1, 1],而像素值需要在 [0, 1]。这个线性变换把范围映射回来。
.clamp(0, 1):裁剪掉可能的越界值,防止转 uint8 时溢出。
.cpu().permute(0, 2, 3, 1):从 PyTorch 的 (batch, channel, height, width) 转成 PIL 需要的 (batch, height, width, channel)。
.numpy()[0]:转 NumPy 并取第一张(batch 里只有 1 张)。
* 255 + round() + astype("uint8"):把 [0,1] 浮点映射到 [0,255] 整数,转成 PIL 图像。这些后处理的术语掌握后,在ComfyUI里自己画管线会更轻送。
这段代码就是一个手工展开的 Pipeline:
| 高层概念 | 在这段代码里 |
|---|---|
| Model(UNet) | model(input, t) 预测噪声 |
| Scheduler | scheduler.step(...) 更新样本、set_timesteps(50) 控制步数 |
| Pipeline 的去噪循环 | 那个 for t in scheduler.timesteps 循环 |
| Pipeline 的后处理 | 反归一化、转 PIL |
它清楚地展示了 diffusers 的解耦设计:UNet 只管“看图猜噪声”,Scheduler 只管“按公式更新”,两者通过标准接口协作。你也可以把 DDPMScheduler 换成 DDIMScheduler 或 PNDMScheduler,循环代码几乎不用改,就能体验不同采样器的速度/质量权衡——这正是模块化带来的灵活性。