>
精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
精通
英语
和
开源
,
擅长
开发
与
培训
,
胸怀四海
第一信赖
大批量采购华为昇腾芯片后,DeepSeek所用芯片一半是英伟达,一半是华为,打破英伟达垄断。这为后续DeepSeek降低成本和算力出口打下基础,同时也间接刺激了华为昇腾芯片的品牌力度,为后续有可能的华为芯片出口打破瓶颈。
这次融资不是直接给DeepSeek公司,是先投资给梁文锋担任 GP(普通合伙人)的有限合伙企业,再由该合伙企业向DeepSeek增资。
DeepSeek融资主要目的是建设内蒙古数据中心,打造国产算力集群,该集群主要用于前沿大模型的预训练,旨在突破英伟达在训练环节的垄断,并深化与华为生态的绑定。
完整的大模型训练通常分三个阶段:1、预训练,2、监督微调(SFT),3、对齐训练(RLHF / RLAIF 等)。还有后训练和持续训练。
训练和人类学习知识进行记忆处理类似,白天学习,晚上复习,重点再背会和书本上对齐。为什么说是人工智能?模仿人类行为,所以叫人工智能。
锐英源软件以前做简单的训练,语音识别训练,语言是蒙语,先对全部数据进行训练一次, 发现哪个音节相关的词识别的不好,就再多采集一些相关的语音文件,再训练,反复迭代,直到常见词汇都能识别才能发布版本。这简单的训练过程和DeepSeek不能比,就是个类比引导。
针对华为昇腾芯片的使用,DeepSeek对代码组件进行了升级开发,比如DeepEP通信库里的代码:
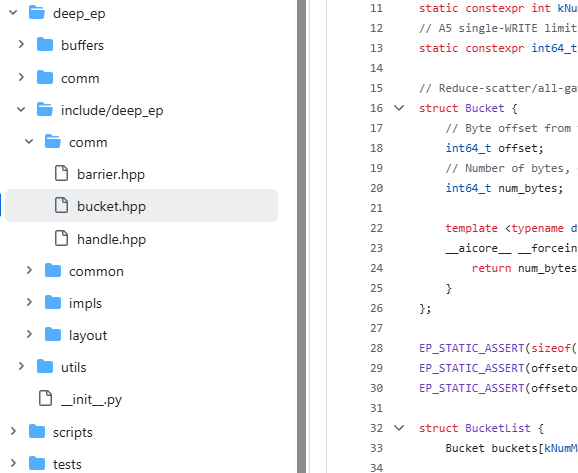
这是DeepEP通信库的C++头文件,还能对应的库,这些头文件和库被Python文件调用,这就是DeepSeek的语言层面的架构。
看到bucket词汇,锐英源软件就想到了以前研究Apache代码时的心得,Apache内存管理里也有bucket桶的概念,心得网页在Apache页面里有。
Apache是进程内内存调度,调度几个G的内存,而DeepSeek量级大的多,不过要想学会,最好从简单学起,学会进程或线程的内存池,才好理解AI大模型的内存管理。
DeepEP是DeepSeek开源的高性能通信库,专为混合专家(MoE)模型和专家并行(EP) 设计,旨在解决大规模分布式 AI 训练和推理中的通信瓶颈,提升GPU利用效率。
DeepEP 的核心是提供高吞吐量、低延迟的 all-to-all GPU 计算核,用于 MoE 模型的派发(dispatch) 和合并(combine) 操作。
高效全对全通信:支持节点内和节点间通信,兼容 NVLink 和 RDMA 高速互联技术。
双内核设计:
高吞吐量内核:用于训练和推理预填充阶段,最大化数据交换效率。
低延迟内核:用于推理解码阶段,采用纯 RDMA 技术,最大限度降低延迟。
原生 FP8 支持:完全支持 FP8 低精度数据格式的调度,有效降低计算资源消耗。
计算与通信重叠:通过基于Hook的方法实现通信与计算的重叠执行,且不占用 SM(流处理器)资源,从而显著提升硬件利用率。DeepEP 说“不占用 SM 资源”,意思是它通过 RDMA、NVLink 异步通信、专用通信核等手段,让数据搬运尽量不消耗通用计算资源,把 SM 留给 GEMM、Attention 等真正的计算任务,从而提升整体吞吐和 GPU 利用率。2026年上半年HBM内存让韩国赚在盆满钵满,在技术和市场目的上和DeepEP类似,都是消除数据供给瓶颈,提升 GPU 利用率。
DeepEP 项目持续快速迭代,近期有两项重要更新:
DeepEP V2:进行了完全重构,统一了高吞吐和低延迟 API 至单一的 EPBuffer 接口,并新增了 NCCL Gin 后端、JIT 编译通信核等特性,支持更大规模的集群部署。
DeepEP-Ascend:DeepSeek 已开源面向华为昇腾(Ascend)950 NPU 的版本,提供相同的 API 和完整性能,实测 Dispatch 带宽达 375 GB/s,Combine 带宽达 347 GB/s,接近硬件上限。
大学生如果想进华为和DeepSeek这些技术概念和细节要掌握,掌握了容易过面试,就是进低一档的企业,也是好就业。