锐英源软件原创内容,禁止转载和任何形式的非法内容使用,违者必究
📑 本文目录
AI对接其实有两种:一种是功能对话,你问它答,用完即走;另一种是数据对话,你得先把资料准备好、整理好,AI才能基于你的数据干活。就像现在AI能自动剪辑视频,前提是你得有一条合格的视频时间线素材。IMA做的,就是帮你把“数据对话”这半边整理清楚的那块敲门砖。
锐英源软件在处理海量网页关键词时,用WorkBuddy开发了网页后台,开发时,指明WorkBuddy要能让数据结果导入到IMA里进行管理和升值。WorkBuddy完美完成了任务,在分析网站时,把结果按md格式进行了输出,而IMA可以导入md格式进行管理。下面是md文件局部展示:
# 站点关键词知识库
> 源站:`F:\ryyweb2`(只读扫描)
> 生成时间:2026-11-18 15:16:35
> 数据版本:schema v1
> 用途:关键词统一管理、SEO 排查、内容选题;结构化源数据见 `keywords.json`。
## 一、总体概况
- 页面总数:**2263**
- 含 keywords 标签页面:**2247**
- 已配置有效关键词页面:**1358**,覆盖率 **60.01%**
- 疑似归档/备份目录页面:**127**
## 二、高频关键词 Top 60
| 排名 | 关键词 | 覆盖页面数 |
网页关键词的升值方向,比如分析出来缺少哪类热门关键词,哪类关键词会拉低整体网站的质量,哪类关键词关联的文章过多或过少,哪些网页加上关键词会让访问量更大,哪些网页的关键词已经没有了优化必要。这类信息用手工来汇总很困难不可能实现,但是用AI,用腾讯IMA,就会很容易,并且也会很快。
网页关键词优化好了,生意也就来了。可能懂行找会问,关键词SEO已经过时了,但GEO和AEO这类数据,IMA一样可以管理,并且管理的很好。
就像IMA先强调笔记管理一样,IMA记忆的笔记够多时,会自动分析出个人助理信息,进行提示,提升你的情绪价值,让你工作顺利。
IMA的安装门槛比很多人想象的低。腾讯电脑管家提供了IMA的一键安装入口,不需要去官网找安装包、不需要处理依赖环境,点一下就能完成部署。对于不习惯折腾软件的用户来说,这一步省掉了很多麻烦。
装好之后,IMA的笔记管理有现成的教学视频可以参考。从基础的文档上传、标签整理,到用AI对笔记内容做扩写、润色、配图,视频里都有演示。这意味着你不需要先成为“AI专家”才能用IMA,跟着操作走一遍,基本就能上手。
IMA更值得说的是它的知识库广场。你可以在广场里订阅其他机构或个人公开发布的知识库,直接基于别人的整理成果进行提问和学习,相当于“观摩”别人怎么建库、怎么组织内容。目前广场里订阅量最高的知识库已经有数十万人订阅,覆盖行业研究、医学指南、教育资料、财经分析等多个垂直领域。这个数字本身就在说明一件事:愿意为“整理好的知识”付费或投入注意力的人,远比想象中多。
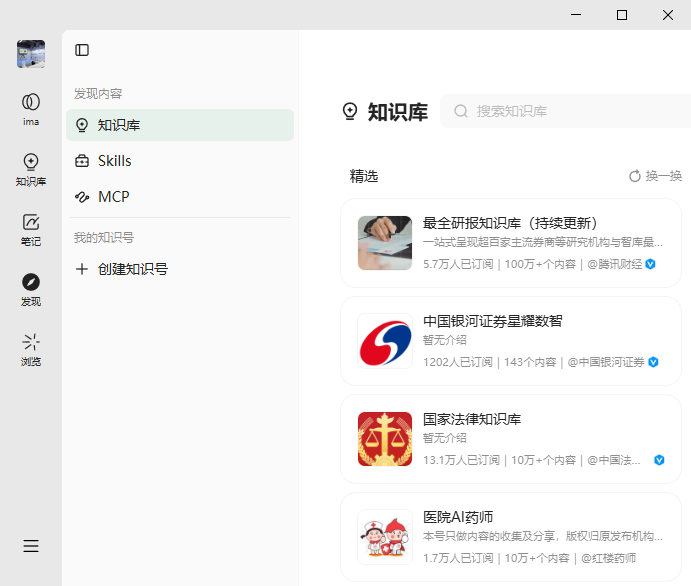
WorkBuddy和IMA的关系,可以用一句话概括:IMA负责“记住”,WorkBuddy负责“干活”。
在WorkBuddy里连接IMA只需要一次微信扫码授权,不需要填API Key、不需要配置环境变量。授权完成后,你在IMA里的个人知识库、共享知识库、订阅知识库都会出现在WorkBuddy的资料库列表中。写方案、做报告、生成PPT的时候,可以直接把IMA里的文件添加到任务里,WorkBuddy会基于你选的资料来生成内容,而不是给一堆通用的模板话。
反过来也成立:WorkBuddy生成的结果可以一键存回IMA知识库,下次再干活的时候接着用。这个“存进去—调出来—用完再存回去”的循环,才是知识库真正产生复利的地方。IMA自己也有官方教程讲这套用法,说明这不是用户自己折腾出来的偏门技巧,而是产品设计时就考虑好的路径。
WorkBuddy里绑定步骤
这里推荐三个IMA值得投入的数据场景:
场景一:垂直行业知识库的订阅与二次整理。知识库广场里已经有人把行业研报、政策文件、专业指南整理好了,你订阅之后可以基于它提问,但更有价值的做法是:把订阅库里的关键内容摘出来,和你自己的项目资料合并成一个新的个人库。IMA支持这种“别人的底子+自己的东西”的混合方式,而混合之后的数据,才是WorkBuddy能直接用来产出定制化内容的东西。
场景二:创作素材的沉淀与风格固化。写公众号、做视频脚本、准备课程内容的人,最头疼的不是没灵感,是每次都要从头翻聊天记录和收藏夹。把选题资料、过往作品、参考案例统一存进IMA,WorkBuddy可以基于这些资料提炼出一份“创作风格画像”存回去,之后每次生成内容都参考它。数据场景的核心不是“存了多少”,是“存的东西能不能被下一次调用直接复用”。
场景三:客户/项目资料的持续跟踪。做服务类工作的人,每个客户的历史沟通、需求变更、交付记录分散在不同地方。把这些资料按客户或项目建库,WorkBuddy在写新方案、做复盘的时候直接调用,不用再翻邮件和聊天记录。生成的新文档再存回去,这个客户的知识库就越用越厚,下次接手同类项目时,启动成本会明显下降。
几十万人订阅一个知识库,这不是小众爱好。它说明市场对“有人把信息整理好、结构化、能被AI调用”这件事有真实需求,而且需求规模不小。IMA在做的,就是降低这个整理过程的门槛;WorkBuddy在做的,是让整理好的数据能直接变成产出。
如果你手上有散落各处的资料,想让它们变成AI能用的东西,或者你想围绕自己的业务建一个能被反复调用的知识库,可以联系锐英源软件。我们在知识整理、RAG数据准备和AI工具落地方面有实际项目经验,联系方式就在页面左侧。
AI对接的下半场是数据对话,而数据对话的前提,是你得先有一份整理好的数据。