锐英源软件精品原创,禁止转载和任何形式的非法内容使用,违者必究
📑 本文目录
想了解清华大学NLP实验室,想学习端侧AI支持的手机端和嵌入式AI开发,请看本文。锐英源软件对软硬件一体开发有兴趣,所以才写本文学习下。
面壁智能和 Liquid AI 在同一条赛道上:做能在手机、汽车、PC 上本地运行的“小模型”。区别在于,面壁的路径更强调 开源换生态 + 国内量产落地,MiniCPM 系列的开源下载量和车型搭载量是它的两张硬牌。
面壁智能从清华大学 NLP 实验室孵化而来,核心路线是“智能密度”——在更小的参数规模里塞进更强的能力。2026 年上半年,公司累计融资超过 50 亿元人民币,投后估值突破200亿元,是端侧智能赛道公开估值最高的独角兽,并已启动A股IPO辅导。
它的产品落地不只在“下载量”层面。MiniCPM系列开源模型由面壁智能与OpenBMB社区联合发布,全球累计下载量已突破6000万次,覆盖文本、视觉、语音全模态。在商业侧,端侧模型已经进入汽车、手机等硬件场景,走的是“模型留在国内、产品随硬件出海”的路线。
面壁智能手机端AI智能体命名为小钢炮智能体助手cmpGO,下面是截图:
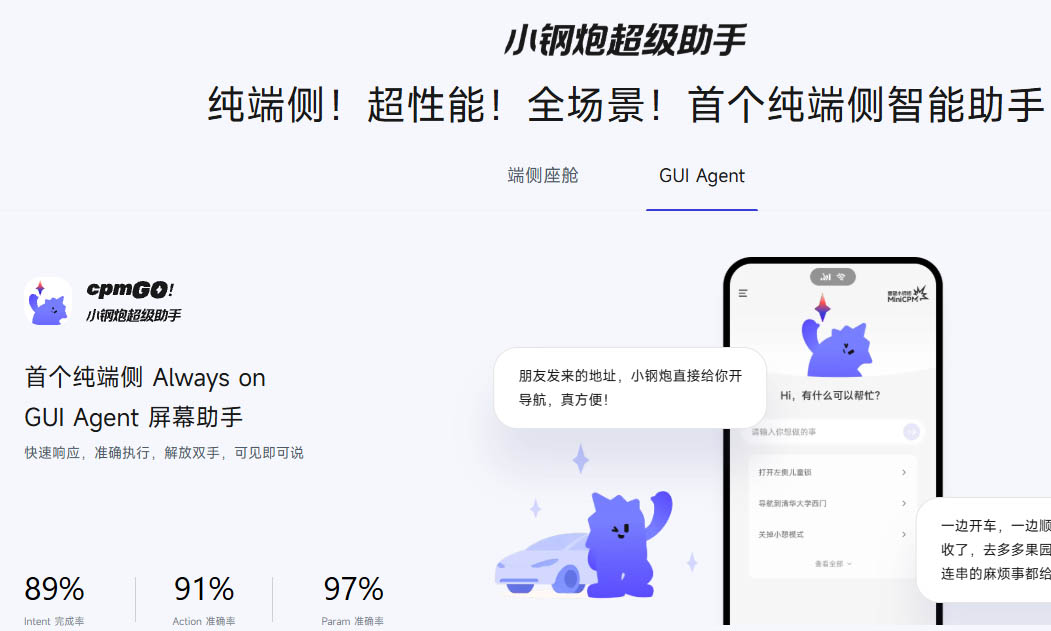
纯端侧就是AI大模型部署在手机上,离线就能使用,并且保证可用性。我在华为手机上想下载看看,暂时还没有,后面会研究部署测试。
2026 年 10 月发布的 MiniCPM-V 4.7 有两个版本,定位差异很清楚:
| 版本 | 参数与架构 | 端侧表现 |
|---|---|---|
| 35B-A3B | 总参数 35B,MoE 架构,每次推理仅激活 3B | 约 3GB 内存,iPhone 17 Pro Max 上解码 13+ token/s,iPad Pro 上 15+ token/s |
| 1B | 实际参数 1.3B | 主打极小体积,OCR、数学和视频理解在同尺寸中属于第一梯队 |
关键突破在于“无损”:35B-A3B 是首个能在端侧流畅运行且不牺牲性能的开源 MoE 模型。视觉压缩开到 16 倍时,MMBench 仅从 91.72 降到 90.87,OCRBench 从 91.20 降到 90.40,省下来的算力几乎没有拿精度去换。纯文本侧,中文知识 CMMLU 拿到 90.21,工具调用 τ2-Bench 拿到 84.65,在同尺寸中处于领先位置。
真实案例:在断网的 iPhone 上,模型拿到一张拿破仑远征俄国的行军路线图,被问“最低气温是多少、出现在哪天、换算过程”。它在不到一分钟内从图上找到零下 30 度的标注,判断日期为 1812 年 12 月 6 日,并按 1 列氏度 = 1.25 摄氏度换算出零下 37.5 度。另一个例子是上传家庭用电调查表,模型逐项完成功率换算、账单归因和省电方案比较。这说明它在端侧不只是“能跑”,而是能完成多步推理和文档理解。
以 MiniCPM5-2B 的官方用法为例,加载和对话模板的使用方式与标准 Hugging Face 流程一致:
from transformers import AutoTokenizer, AutoModelForCausalLM


model_id = "openbmb/MiniCPM5-2B"

tokenizer = AutoTokenizer.from_pretrained(model_id)

model = AutoModelForCausalLM.from_pretrained(model_id, device_map="auto")


messages = [{"role": "user", "content": "Who are you?"}] #对话张量

inputs = tokenizer.apply_chat_template(

    messages,

    add_generation_prompt=True,

    tokenize=True,

    return_dict=True,

    return_tensors="pt",

).to(model.device) #对话输入


outputs = model.generate(**inputs, max_new_tokens=256)#以token数256调用大模型

print(tokenizer.decode(outputs[0][inputs["input_ids"].shape[-1]:]))

#[inputs["input_ids"].shape[-1]:] 是一个切片操作。它从“输入长度”开始截取,直到序列末尾。
这是Python大模型推理经典代码,tokenizer负责转换自然语言值到大模型理解的token,也负责把结果转换为自然语言,前者对应函数是apply_chat_template,后者对应decode。中间调用大模型是generate函数。
apply_chat_template里参数意思为:
| add_generation_prompt=True | 在序列末尾追加一个生成提示符(类似 <|assistant|> 的起始 token),告诉模型"轮到你了,开始生成"。如果不加这个,模型会以为对话还没结束,可能继续补全用户的话而不是做出回应。 |
| tokenize=True | 将上述所有内容(文本 token、图像嵌入占位符、音频嵌入占位符、工具 schema)统一 tokenize 成整数 ID 序列。 |
| return_dict=True | 返回一个字典(通常包含 input_ids、attention_mask,多模态场景下还可能有 pixel_values、audio_features 等),而不是裸张量。这样 model.generate(**inputs) 可以用关键字参数直接解包。 |
| return_tensors="pt" | 指定返回 PyTorch 张量("pt"),而非 NumPy 或 TensorFlow 格式。 |
.to(model.device):把上述所有张量搬到模型所在的设备(GPU 或 CPU)。多模态输入的数据量较大,这一步确保后续推理不会因为设备不匹配而报错。
如果要在 GPU 上提供多用户服务,vLLM 是面壁官方支持的高吞吐路径。以下命令直接来自 OpenBMB 知识库:
vllm serve openbmb/MiniCPM-V-4.7-1B \

  --dtype auto \

  --max-model-len 8192 \

  --gpu-memory-utilization 0.9
启动后即可通过 OpenAI 兼容接口调用。--max-model-len 控制上下文长度,--gpu-memory-utilization 控制显存占用比例,需要根据实际显卡调整。
MiniCPM-V 4.7 的官方部署文档把 llama.cpp 和 Ollama 定位为“本地与端侧运行” 的路径。Ollama 适合快速在笔记本上试用;llama.cpp 则适合嵌入到需要 C/C++ 调用的端侧程序中。官方还提到 v4.7 需要 transformers >= 5.18.0,但各推理框架可以在不依赖 trust_remote_code 的情况下工作。
部署Linux环境,添加大模型,用C++调用MiniCPM大模型,再进行验证和优化,这就是嵌入式环境里AI开发的简单总结。现在有硬件能够嵌入自带一些大模型,但支持行业有限,能力有限。
主要来源:OpenBMB 知识库 openbmb.cn;Hugging Face 模型卡与讨论区;智东西、量子位等公开报道。